프로젝트/07
SELF Studio
텔레그램에서 도는 개인 학습 관리 시스템
라우터 하나가 141개 노드입니다.
한 줄
텔레그램 메시지 하나를 받아 의도를 분류하고 적절한 하위 워크플로우로 넘기는 라우터를 중심으로, 학습 콘텐츠 추천·마감 감시·답안 채점·주간 리포트가 붙어 있는 개인 학습 관리 시스템입니다.
문제
배우려는 것은 계속 늘어나는데, 무엇을 언제 다시 봐야 하는지는 관리되지 않았습니다. 마감이 있는 일은 잊고, 읽은 자료는 다시 꺼내지 않게 됩니다.
앱을 하나 더 까는 방식은 처음부터 배제했습니다. 이미 하루에 수십 번 여는 텔레그램 안에서 끝나야 실제로 쓰게 됩니다.
구성
운영 워크플로우 여섯 개와 점검용 하나로 나눴습니다.
- 라우터 — 텔레그램 메시지를 받아 의도를 분류하고 하위 작업으로 넘깁니다. 이 시스템의 중추이며 노드 141개로 가장 큽니다. 아침 읽을거리 선정과 온보딩 검토에 Anthropic·Perplexity를 호출하고, 일정은 Google Calendar와 연동합니다
- 에러 알림 — 다른 워크플로우가 실패하면 에러를 포맷해 알립니다
- 학습 콘텐츠 추천 — 매시 정각에 지금 꺼내 볼 만한 자료를 판정합니다
- 마감 감시 — 15분마다 마감이 임박한 항목을 확인합니다
- 답안 채점 — 텍스트나 음성으로 보낸 답안을 채점하고 결과를 저장합니다. 음성은 Whisper로 받아 적습니다
- 주간 리포트 — 매주 일요일 저녁에 한 주 학습 통계를 집계합니다
- 봇 신원 확인(점검용) — 봇 토큰이 맞는 봇을 가리키는지 수동으로 확인합니다. 잘못된 토큰으로 활성화하면 기존 봇 4개가 조용히 죽기 때문에 만든 안전장치입니다
설계 판단
하나의 거대한 워크플로우 대신 라우터 + 하위 작업 구조로 나눴습니다. 알림과 채점과 리포트를 한 덩어리에 넣으면 하나를 고칠 때마다 전체를 건드리게 됩니다. 진입점만 하나로 두고 실제 작업은 분리했습니다. 그 결과 라우터가 커졌지만, 커진 곳이 한 곳뿐이라 관리가 됩니다.
AI는 학습의 앞뒤에만 둡니다. 만들고 나서 세어 보니 전체 166노드 중 LLM을 부르는 곳은 세 곳뿐이었고 전부 채점기 안에 있었습니다. "이건 자동화지 AI 학습법은 아니지 않나"라는 자문에 절반은 그렇다고 답했습니다. 핵심이라던 재작성 검사조차 AI가 아니라 한국어 조사를 떼고 음절 3-gram 겹침 비율을 계산하는 결정론적 코드입니다. 다만 절반은 의도한 설계입니다. 읽기·재작성·실행은 사람이 직접 해야 효과가 나므로 AI가 대신하면 안 됩니다. AI는 앞(무엇을 읽을지 고르기)과 뒤(무엇이 부족한지 진단하기)에만 두고, 이후 개선도 그 원칙 안에서만 했습니다.
성능 문제를 감이 아니라 실측으로 잡았습니다. 반응이 느려졌을 때 노드 하나당 약 3.5초의 저장 지연이 발생하는 것을 확인했고, 원인이 실행 진행 상황 저장 옵션임을 특정해 제거했습니다. 141노드 라우터의 실행 시간이 60초에서 8.3초로 줄었습니다. 노드가 많은 워크플로우였기 때문에 이 설정 하나가 체감 속도를 좌우했습니다.
첫 실사용에서 설계 결함 3건이 드러났습니다. 처음 한 바퀴를 돌린 날 "완전 개념없는 봇"이라는 자평이 나왔고, 로그로 확인하니 자료 유형 미분류, 추천 경로 사망, 의도 판정 부재 세 가지가 한꺼번에 드러난 것이었습니다. 만들 때는 보이지 않다가 실제로 쓰면서 나온 것들이고, 당일 수정했습니다. 설계 단계에서 다 잡을 수 있다는 생각을 접게 된 경험입니다.
결과와 한계
현재 운영 중이며 사용자는 저 한 명입니다. 학습 효과를 정량적으로 측정하지는 않았고, 주간 리포트의 통계도 사용 기간이 짧아 추세를 말하기 이릅니다. 다른 사람이 쓰려면 계정 분리와 데이터 격리가 먼저 필요합니다. 채점은 한 모델의 판정에 의존하며 재시도 경로만 있습니다.
화면과 시연
- 스크린샷 — 라우터 워크플로우 캔버스 전체 (141노드 규모가 보이는 축소 뷰)
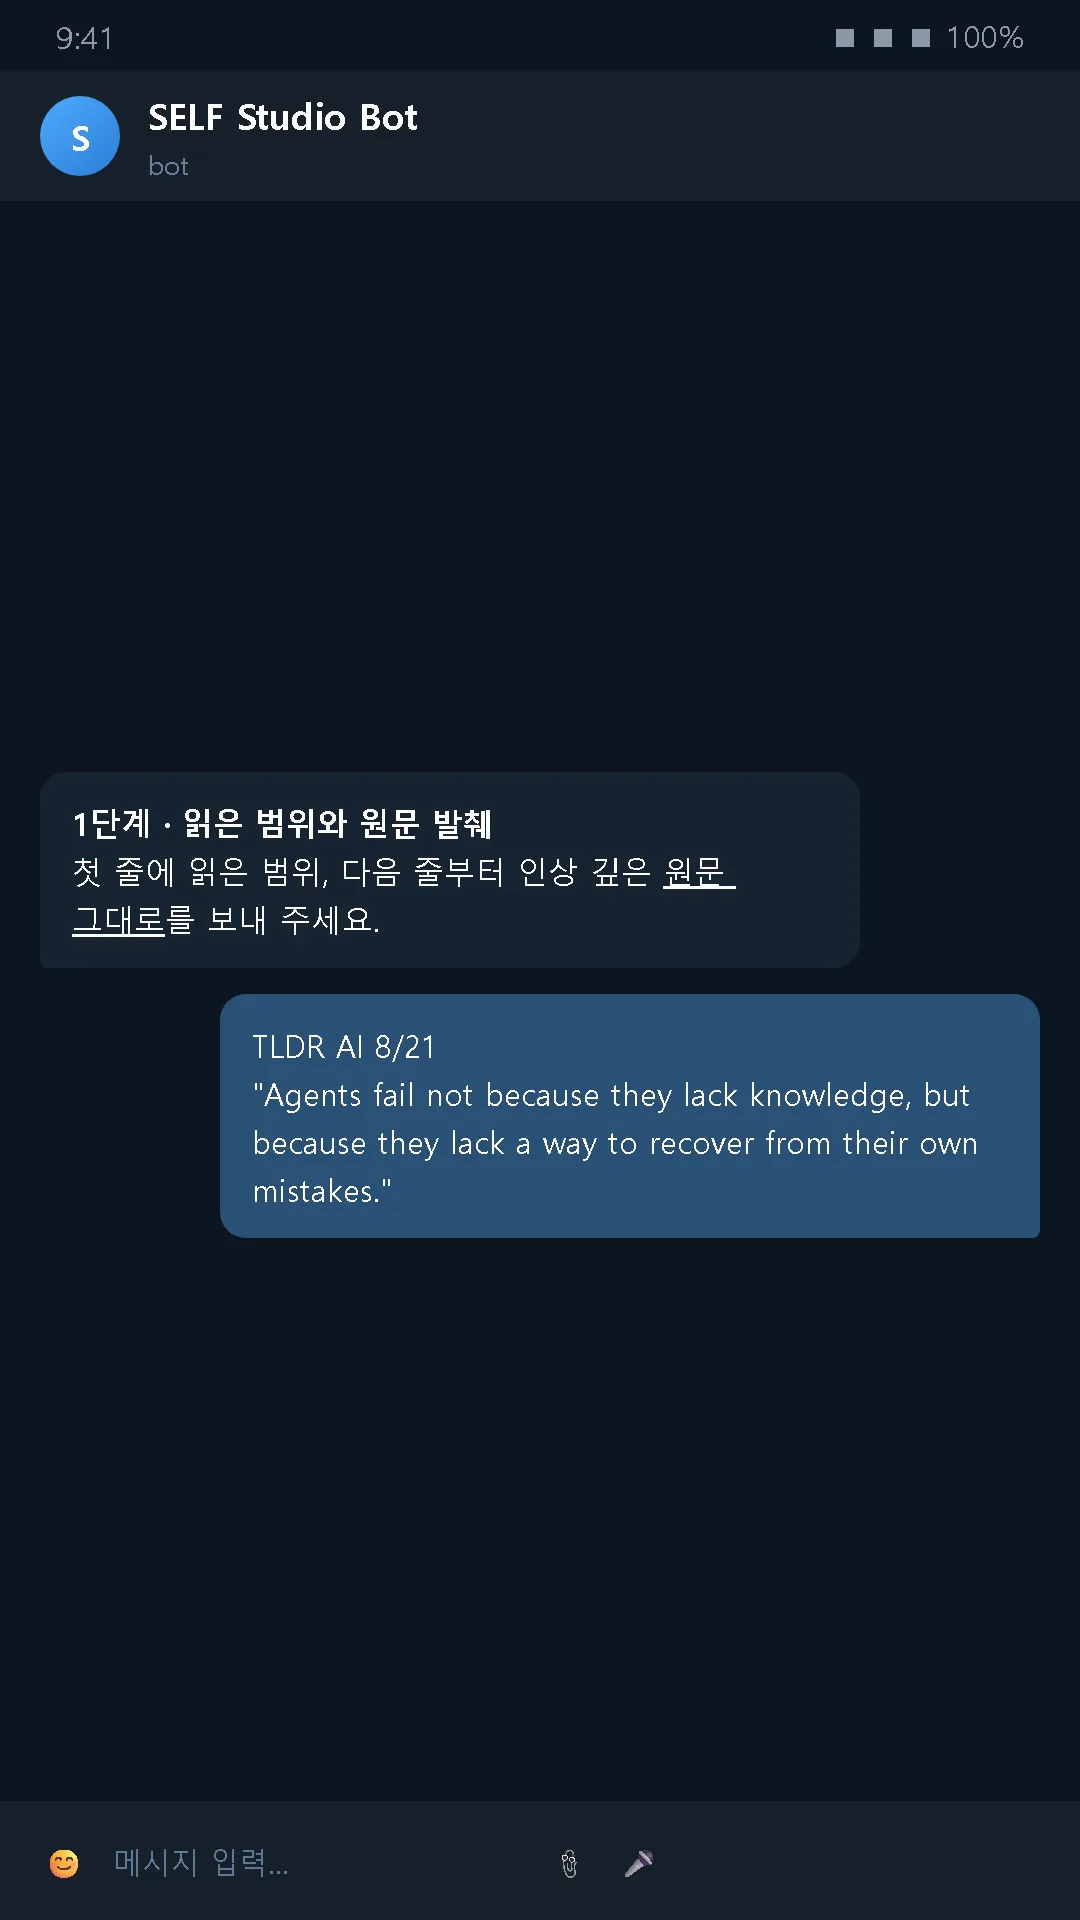
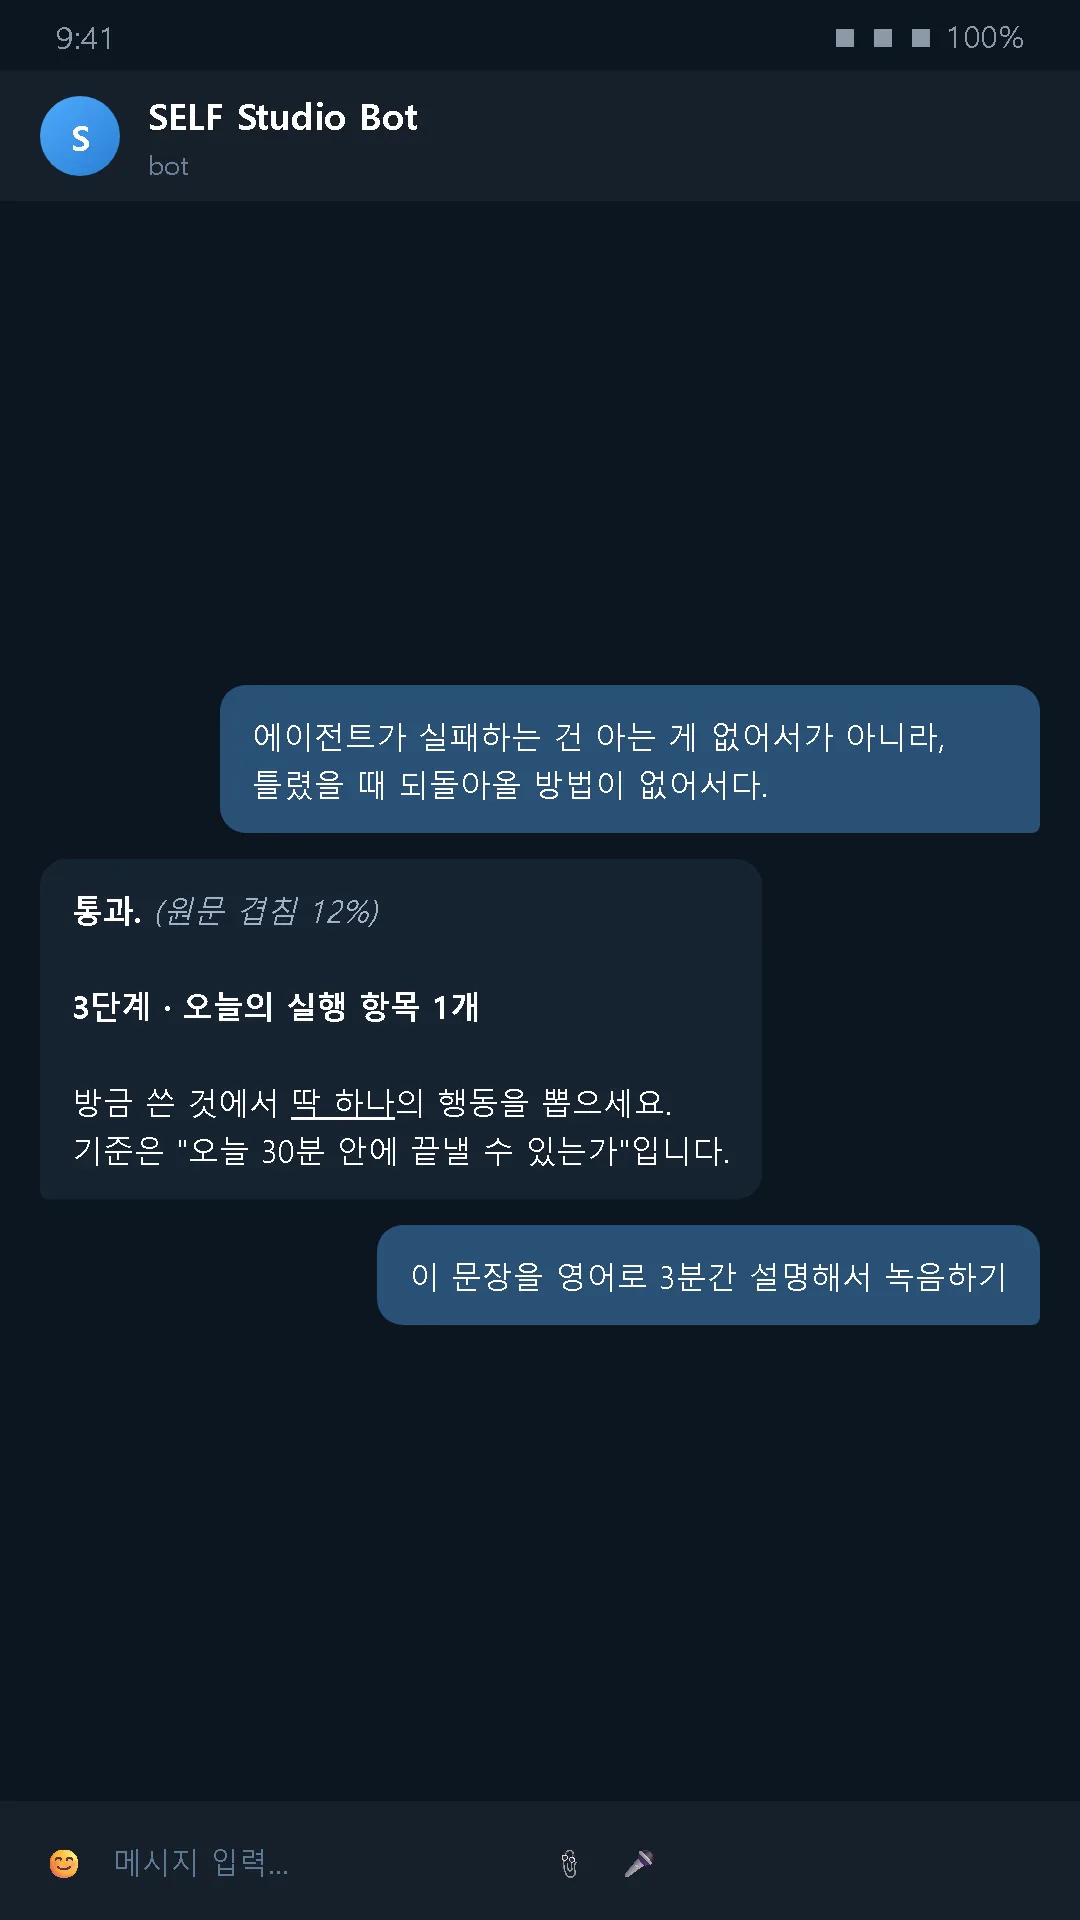
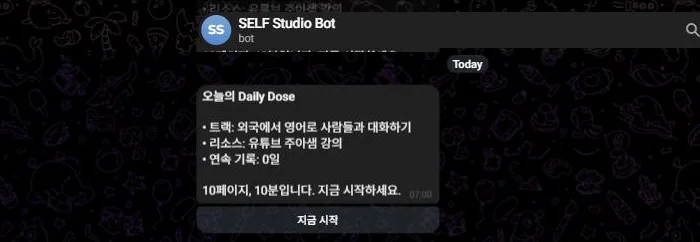
- 스크린샷 — 텔레그램에서 학습 알림과 채점 결과를 받는 화면
- 스크린샷 — 주간 리포트 메시지