프로젝트/08
지식 볼트 자동화
삭제 사고를 막는 동기화 파이프라인
자동화에서 삭제는 되돌릴 수 없는 유일한 동작입니다.
한 줄
Notion에 흩어진 기록을 Obsidian으로 단방향 동기화하고, 빈 껍데기 노트와 경로 변경 잔재만 골라 지우는 자동화, 그리고 볼트 전체를 검색 가능하게 만드는 RAG 파이프라인입니다.
문제
기록은 계속 쌓았는데 다시 꺼내 쓰지 못했습니다. 회의록과 과제 메모가 시간 순으로만 쌓이면서, 반년 전 판단을 찾으려면 페이지를 하나씩 열어야 했습니다.
두 번째 문제는 AI 에이전트에게 정리를 맡기면서 생겼습니다. 제가 쓴 원본과 AI가 만든 요약이 섞이기 시작했고, 나중에는 어느 쪽이 사실인지 구분할 수 없게 됩니다.
내가 한 일
- 단방향 동기화 — Notion에서 Obsidian 방향만 열었습니다. 양방향은 충돌 해결 비용이 크고 원본이 오염될 위험이 있습니다. 실행 전 결과만 보는 확인 모드를 기본으로 뒀습니다.
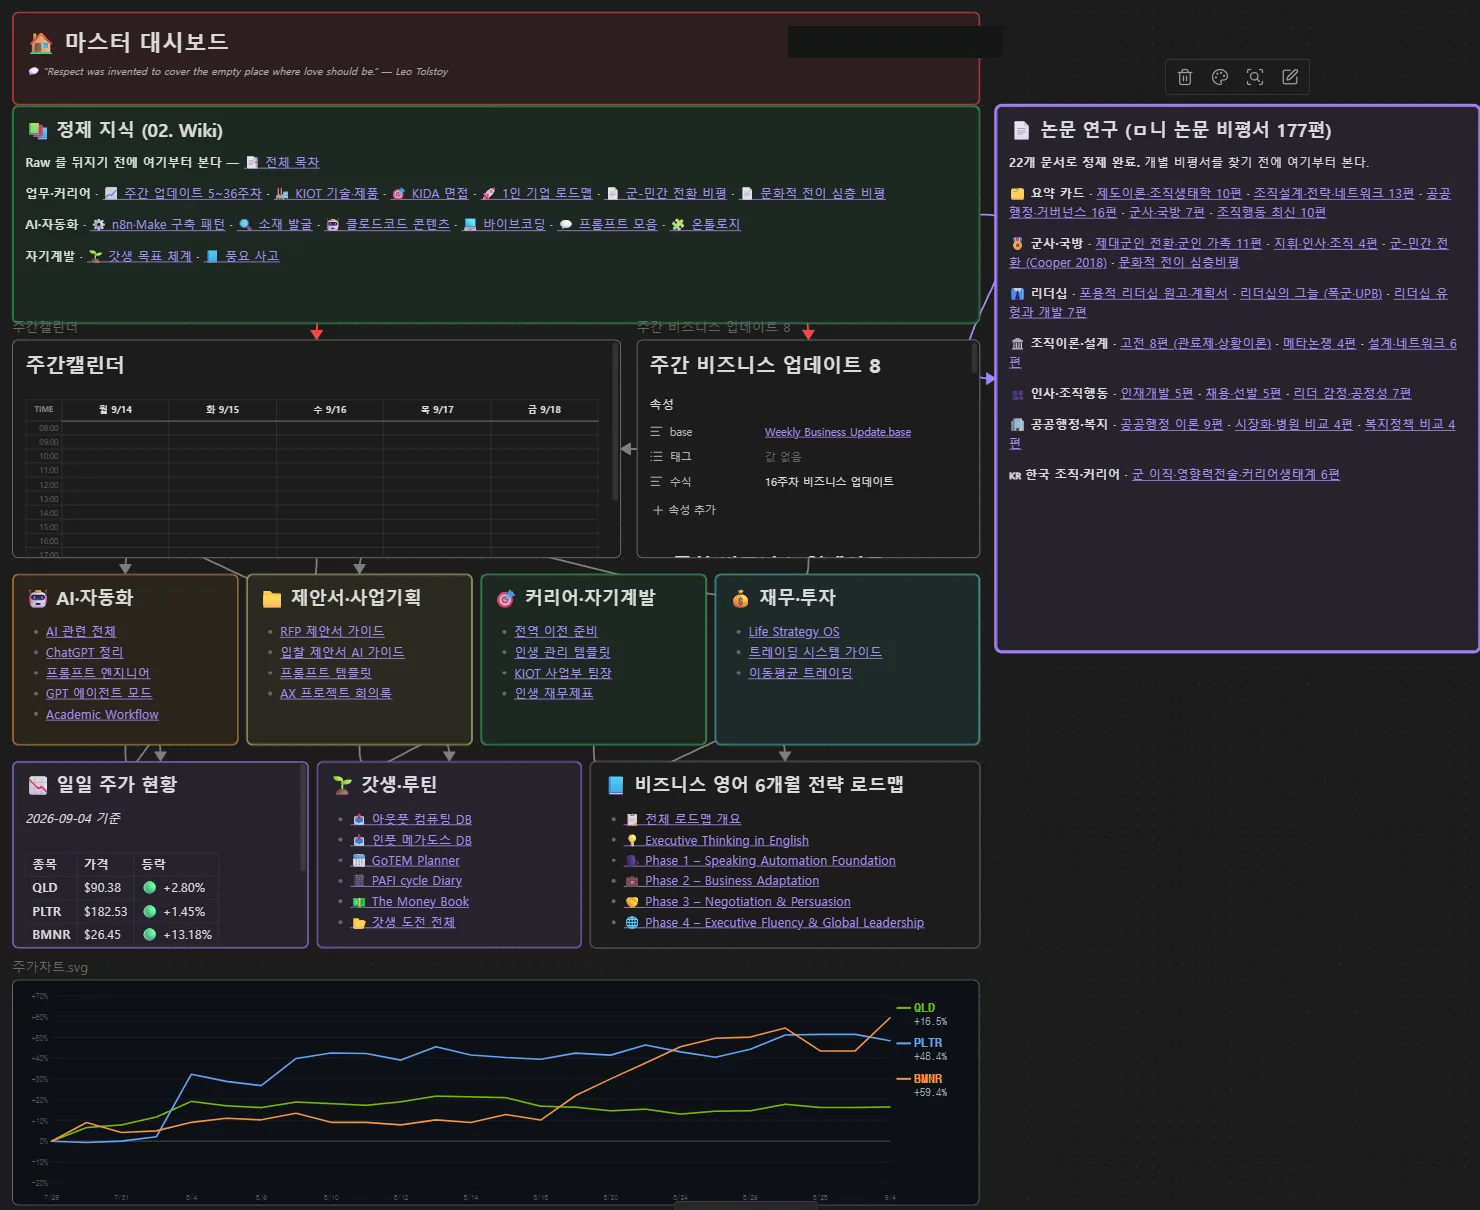
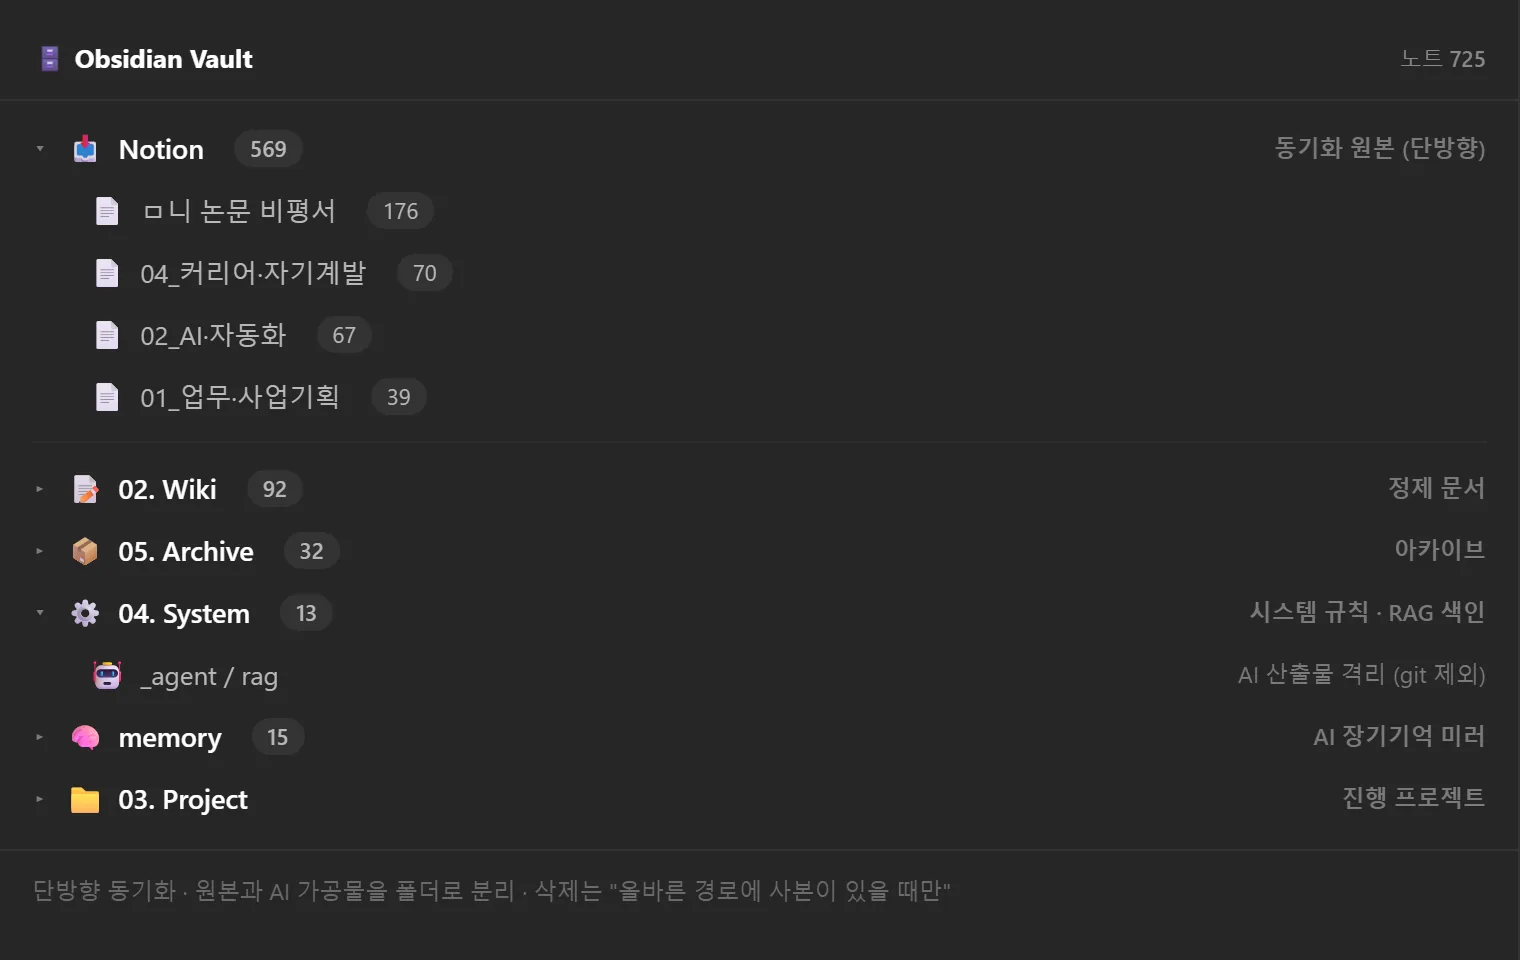
- 볼트 구조 분리 — 정제 문서, 시스템 규칙, 아카이브, Notion 동기화 원본, AI 장기기억 미러를 최상위 폴더로 나눴습니다. 현재 동기화 원본 569건, 정제 문서 92건, 아카이브 32건, 전체 725건 규모입니다.
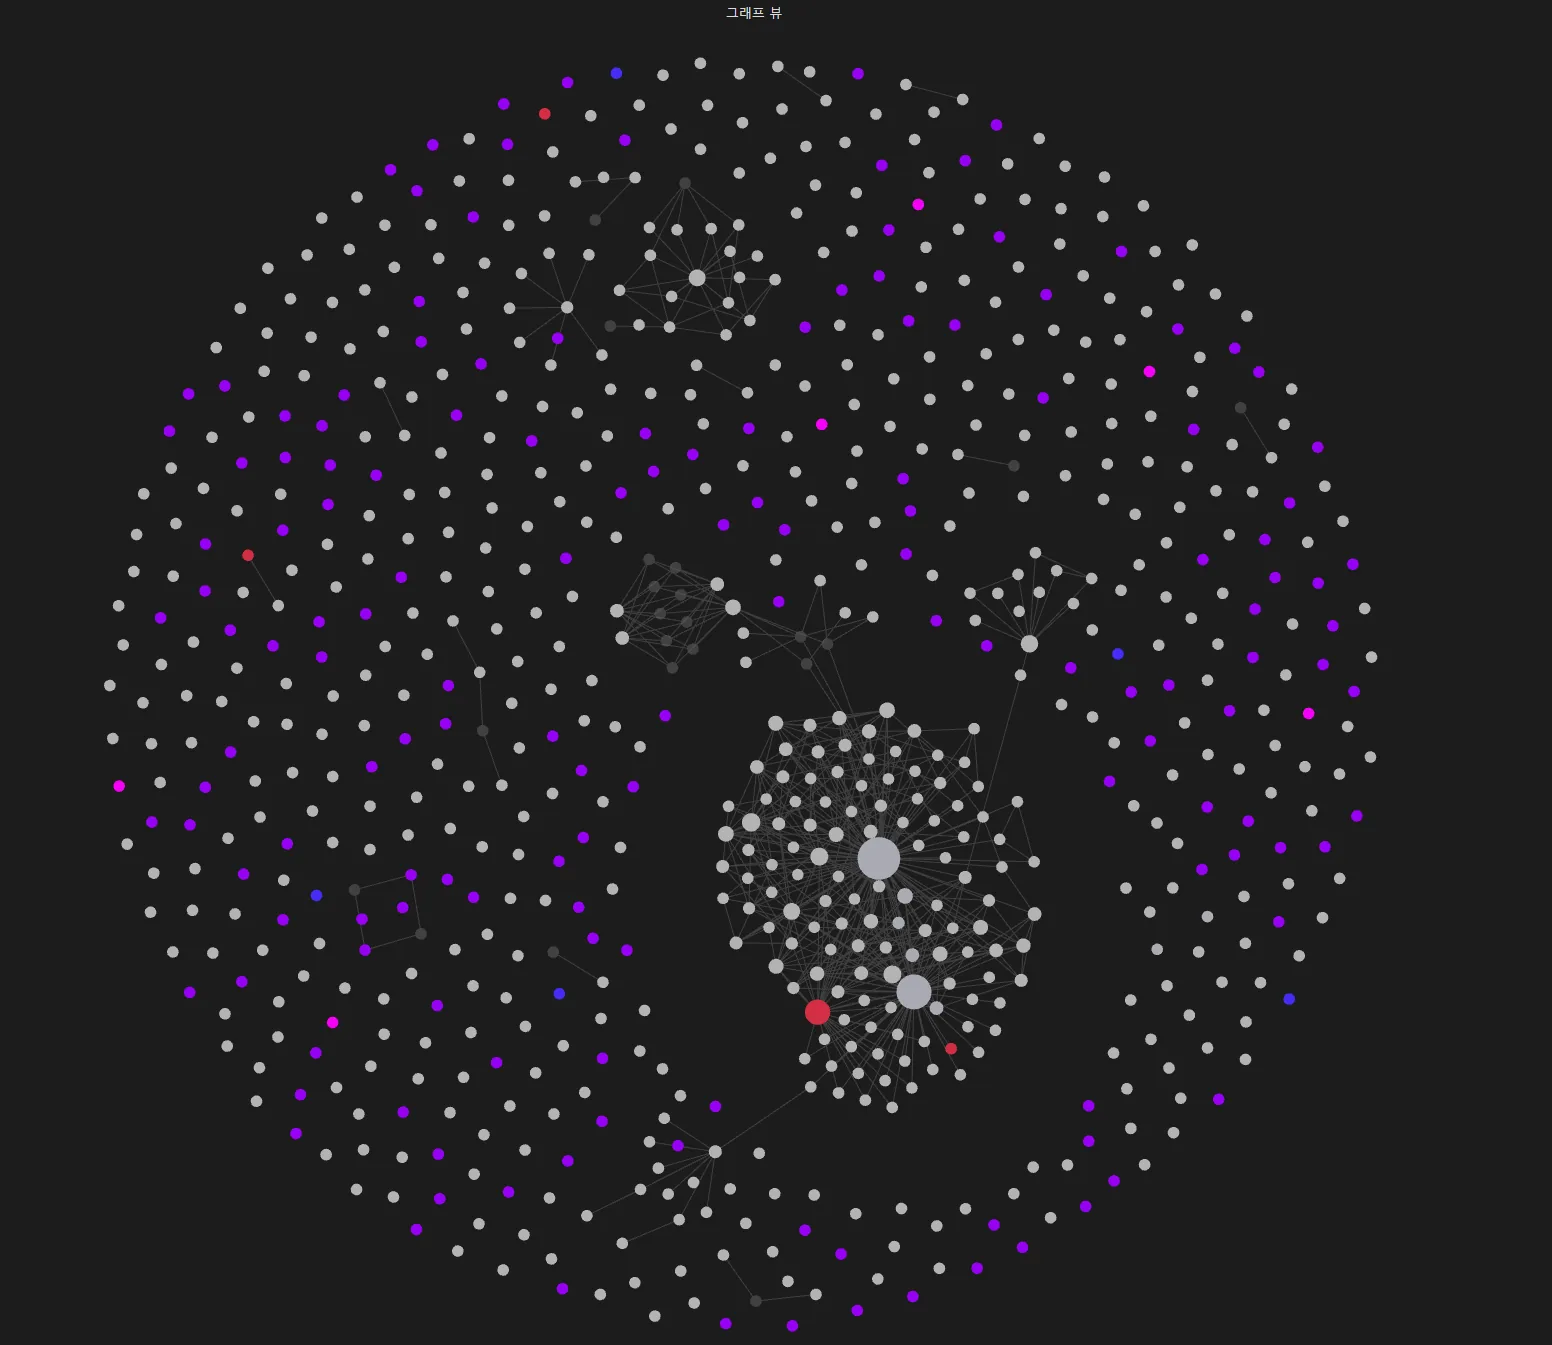
- 동기화 제외 규칙 — 가계부·할일처럼 행 하나가 노트 하나로 쏟아지는 기록성 DB는 통째로 뺐습니다. 검색과 그래프만 어지럽히고 지식으로서 값어치가 없습니다. 계정·비밀번호가 평문으로 있는 페이지는 제목이 아니라 ID로 제외해, 제목을 바꿔도 계속 걸리게 했습니다.
- 정리 스크립트 — 빈 껍데기 노트 정리, 경로 변경 후 남은 옛 사본 정리, 노트 가치 판정(최소 글자 수 기준), 문서 출처 해시 기록, 이 작업들을 매일 돌리는 러너까지 직접 만들었습니다.
- RAG 파이프라인 — 볼트를 청크로 나눠 로컬 ONNX 모델로 임베딩하고, BM25 키워드 검색과 의미 검색 결과를 RRF로 합산합니다. 외부 API 비용이 없고 전체 재계산에 1분이 안 걸립니다. MCP 서버로 노출해 AI 도구가 대화 중에 볼트를 직접 조회합니다.
- AI 장기기억 미러 — Claude의 메모리 파일을 볼트 안에 함께 동기화해, 집과 회사 PC 사이에서 판단의 맥락이 끊기지 않게 했습니다.
설계 판단
경로 계산 로직을 하나로 합쳤습니다. 동기화와 정리가 각자 Notion 트리를 경로로 바꾸다 보니 계산이 어긋났고, 멀쩡한 노트를 지우는 사고가 났습니다. 이후 트리 변환 로직을 공용 모듈 하나로 통합해 두 작업이 같은 결과를 보게 했습니다.
삭제 조건을 좁혔습니다. 이 프로젝트에서 가장 중요한 판단입니다. 처음에는 "Notion 검색 결과에 없으면 삭제"를 기준으로 삼으려 했습니다. 그런데 실측해 보니 Notion 검색 API가 데이터베이스 행을 전부 돌려주지 않았습니다. 그 기준을 그대로 썼다면 주간 업무 기록과 논문 비평서를 포함해 94건이 지워질 뻔했습니다. 실행 직전 표본 검증에서 잡았습니다.
그래서 삭제 조건을 "같은 파일명이 올바른 경로에도 존재할 때만"으로 바꿨습니다. 자동화에서 삭제는 되돌릴 수 없는 유일한 동작이라, 판정 근거가 완전한 데이터인지 먼저 확인해야 한다는 것을 이 건에서 배웠습니다.
검색 순위에 문서당 상한을 뒀습니다. 점수순으로만 자르면 긴 문서가 상위를 통째로 가져가 다른 문서가 보이지 않습니다. 한 문서에서 가져오는 청크 수를 기본 2개로 제한하고, 계층·태그 필터는 검색 전에 걸어 상위 결과가 필터로 비는 일을 막았습니다.
AI 산출물을 격리했습니다. 에이전트가 만든 결과물은 시스템 폴더 아래에만 둡니다. 사람이 쓴 기록과 물리적으로 분리됩니다. 검색 색인 산출물도 저장소 밖에 두고 원본에서 언제든 다시 만듭니다.
Notion을 건드리지 않았습니다. 이미 돌아가는 기록 습관을 바꾸면 기록 자체가 끊깁니다. 입력은 익숙한 곳에 두고 구조화는 받는 쪽에서만 했습니다.
결과와 한계
원본과 가공물의 경계가 생겼고, 삭제 예정이던 기록을 잃지 않았습니다. 다만 이 체계는 1인 사용 기준이며, 검색 품질을 정량적으로 측정하지는 않았습니다.
화면과 시연
볼트 노트 본문이 화면에 찍히지 않도록 폴더 트리와 실행 로그 위주로 촬영합니다.
- 스크린샷 — 볼트 폴더 트리 (원본·정제·아카이브·AI 미러 구분이 보이게)
- 스크린샷 — 동기화 확인 모드 실행 로그
- 스크린샷 — RAG 검색 결과 화면